Die meisten Unternehmen können einen Notfallwiederherstellungsplan vorweisen. Weitaus weniger können jedoch dessen Funktionsfähigkeit beweisen. Diese Diskrepanz zwischen einem Plan auf dem Papier und einem Plan, der sich in der Praxis bewährt hat, misst die Notfallwiederherstellung im Unternehmen – und sie bleibt meist unsichtbar, bis ein Unternehmen sie am dringendsten benötigt.
Laut dem Bericht „State of Disaster Recovery Preparedness 2026“ des Disaster Recovery Journal geben über 75 % der Unternehmen an, über ein formelles Notfallwiederherstellungsprogramm zu verfügen, weitere 16 % planen die Implementierung eines solchen Programms innerhalb des nächsten Jahres. Theoretisch scheint die Bereitschaft nahezu flächendeckend zu sein. Dieselbe Studie bestätigt jedoch nicht, ob diese Programme unter den Bedingungen eines Ausfalls mehrerer Systeme und Standorte getestet wurden, wie er tatsächlich einen unternehmensweiten Vorfall kennzeichnet.
Dieser Artikel erläutert, was einen dokumentierten Notfallwiederherstellungsplan von einem getesteten Plan unterscheidet, wie die Notfallwiederherstellung tatsächlich funktioniert, was typischerweise als erstes versagt, wenn ein ungetesteter Plan auf die Komplexität eines realen Unternehmens trifft, worauf man bei Notfallwiederherstellungslösungen achten sollte und bietet eine praktische Checkliste, um herauszufinden, welche Art von Plan man tatsächlich hat.
Datensicherung, Notfallwiederherstellung und Unternehmenswiederherstellung sind nicht dasselbe.
Diese drei Begriffe werden oft synonym verwendet, weshalb die Diskrepanz häufig unbemerkt bleibt. Backup und Recovery beschreiben den Mechanismus : Besitzen Sie eine nutzbare Kopie Ihrer Daten und können Sie diese wiederherstellen? Disaster Recovery hingegen ist der Plan : der dokumentierte Prozess, die Failover-Strategie sowie die Ziele für Wiederherstellungszeit und -punkt zur Wiederherstellung von IT-Systemen nach einem Störfall – das, was die meisten unter Disaster Recovery für Unternehmen verstehen . Enterprise Recovery beschreibt das Ergebnis: Kann das Unternehmen den Betrieb in seiner vollen Größe und Komplexität, über mehrere Standorte, Workloads und Teams hinweg, wieder aufnehmen – und nicht nur in einer simulierten Planspiel-Situation?
Stellen Sie sich ein mittelständisches Unternehmen vor, das täglich Backups erstellt, über ein schriftliches Failover-Verfahren für sein primäres Rechenzentrum verfügt und noch nie getestet hat, was passiert, wenn der sekundäre Standort während desselben regionalen Ereignisses, das den primären Standort lahmgelegt hat, ebenfalls ausfällt. Dieses Unternehmen verfügt über Backups und einen Notfallwiederherstellungsplan. Eine unternehmensweite Wiederherstellung fehlt jedoch noch, da niemand bestätigt hat, dass der Plan auch im Ernstfall – wenn beide Standorte gleichzeitig betroffen sind – praktikabel ist.
Die meisten Anbieter verwenden Disaster Recovery und Enterprise Recovery nahezu synonym. Der praktische Unterschied ist jedoch entscheidend: Ein Enterprise-Recovery-Plan kann zwar die ersten beiden Definitionen erfüllen, aber dennoch die dritte nicht erfüllen – und genau hier liegt das Problem der meisten Unternehmen. Eine detaillierte Beschreibung dessen, was Disaster Recovery konkret umfasst, finden Sie unter „ Was bedeutet Disaster Recovery eigentlich?“.
Dokumentierter vs. getesteter Wiederherstellungsplan
Die obige Abbildung im Disaster Recovery Journal beschreibt die Existenz eines Programms, nicht dessen Leistungsfähigkeit. Sie misst nicht, ob sich ein bestimmter Notfallwiederherstellungsplan unter realen, sich verstärkenden Ausfallbedingungen bewährt hat – also wenn mehrere Systeme gleichzeitig ausfallen und nicht nur ein einzelner sauberer Failover durchgeführt wurde.
Die Folgen eines Fehlers in diesem Bereich sind hinlänglich bekannt. Laut einer Studie von Splunk aus dem Jahr 2026 , die in Zusammenarbeit mit Cisco ThousandEyes durchgeführt wurde, belaufen sich die Gesamtkosten ungeplanter Ausfallzeiten in den Global 2000-Unternehmen auf 600 Milliarden US-Dollar jährlich, wobei die durchschnittlichen Kosten eines Vorfalls 15,000 US-Dollar pro Minute erreichen. Speziell im Unternehmensbereich ergab die ITIC-Studie „Hourly Cost of Downtime“, dass über 90 % der mittelständischen und großen Unternehmen mehr als 300,000 US-Dollar pro Stunde durch Ausfallzeiten verlieren, wobei 41 % Verluste zwischen 1 Million und 5 Millionen US-Dollar oder mehr pro Stunde melden.
Keine dieser Zahlen beantwortet die Frage, die für eine bestimmte Organisation tatsächlich von Bedeutung ist: nicht die allgemeinen Kosten von Ausfallzeiten, sondern ob der spezifische Plan dieser Organisation in ihrem spezifischen Umfang Bestand haben wird.
| Aspekt | Dokumentierter Plan | Getesteter Plan |
|---|---|---|
| Failover | Es wird davon ausgegangen, dass es funktioniert. | Verifiziert unter simuliertem Mehrsystemausfall |
| Wiederherstellungszeit | Als Ziel angegeben | Gemessen am tatsächlichen Ziel |
| Geltungsbereich | Gilt für ein einzelnes System oder einen einzelnen Standort | Validiert anhand realer Arbeitslasten und Website-Komplexität |
| Eigentumsstruktur | Verfasst von der IT-Abteilung | Durch einen unabhängigen Test oder eine Zertifizierung bestätigt. |
Ein im Notfallwiederherstellungsplan festgelegtes Wiederherstellungsziel von vier Stunden ist ein Zielwert, kein tatsächliches Ergebnis. Wurde dieses Zielwert bisher nur in einer Planspielübung getestet, bei der ein Moderator den Ablauf erläutert, anstatt dass ein Team die Wiederherstellung tatsächlich durchführt, gibt es keine Beweise dafür, dass es unter realen Bedingungen mit Abhängigkeiten, Datenmengen und menschlichen Fehlern Bestand hat. Die Diskrepanz zwischen Zielwert und Realität wird erst im schlimmsten Fall, während eines tatsächlichen Vorfalls, sichtbar.
Wie die Unternehmenswiederherstellung tatsächlich funktioniert
Die Wiederherstellung eines Unternehmens ist ein sequenzieller Prozess, wobei der größte Nutzen im letzten Schritt liegt, dem Schritt, den die meisten Pläne auslassen.
- Schützen und verschlüsseln. Die Daten werden an der Quelle gesichert und verschlüsselt, wodurch die Wiederherstellungspunkte entstehen, auf die bei einer Wiederherstellung zurückgegriffen wird.
- Priorisieren. Die Prioritäten für die Wiederherstellung werden im Voraus festgelegt, sodass die Systeme, die für das Unternehmen am wichtigsten sind, zuerst wiederhergestellt werden, und nicht das System, das sich gerade am einfachsten wiederherstellen lässt.
- Wiederherstellen und testen. Die Wiederherstellungsprüfung verifiziert, dass ein Wiederherstellungspunkt tatsächlich ein funktionierendes System erzeugt und nicht nur eine im Speicher vorhandene Datei.
- Bestätigen. Die Validierung nach einem Vorfall dokumentiert, was funktioniert hat und was nicht, sodass der nächste Test oder der nächste reale Vorfall von einer besseren Ausgangslage als beim letzten ausgeht.
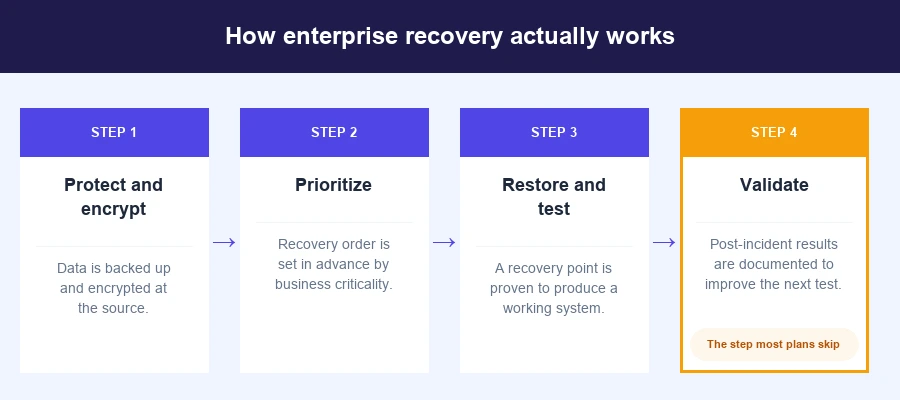
Dieser letzte Schritt, die Validierung nach dem Vorfall, unterscheidet eine wirklich bewährte Datenwiederherstellung im Unternehmen von einem Prozess, dessen Funktionsfähigkeit lediglich angenommen wurde. Wird dieser Schritt ausgelassen, bleibt jeder vorherige Schritt reine Dokumentation, unabhängig davon, wie gut die ersten drei Schritte ausgeführt wurden.
Was fällt bei Unternehmen zuerst aus?
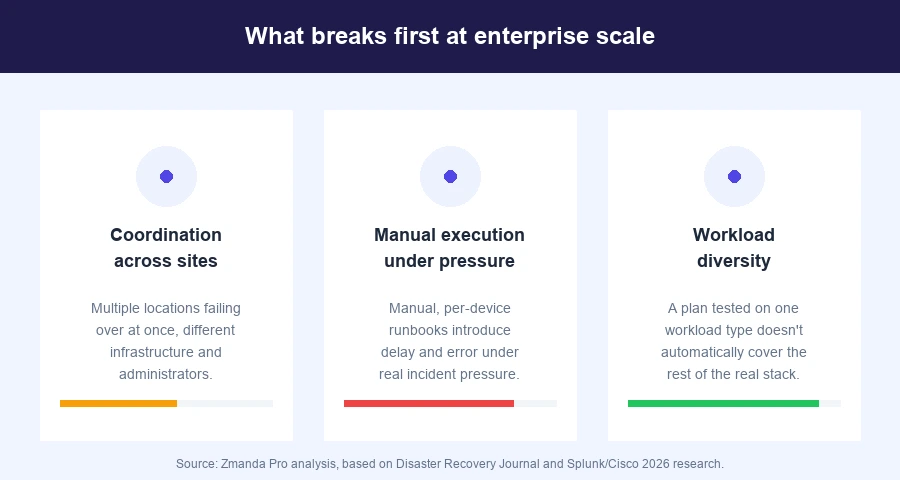
Ein Wiederherstellungsplan, der für ein einzelnes System entwickelt und getestet wurde, hält selten stand, sobald die Komplexität eines echten Unternehmens ins Spiel kommt. Drei Dinge fallen in der Regel zuerst aus.
Standortübergreifende Koordination : Ein Plan, der von einem einzigen Rechenzentrum ausgeht, berücksichtigt selten, was passiert, wenn mehrere Standorte gleichzeitig ausfallen müssen, jeder mit unterschiedlicher Infrastruktur, unterschiedlichen Administratoren und unterschiedlichen Abhängigkeiten.
Manuelle Ausführung unter Zeitdruck : Wiederherstellungs-Runbooks, die auf der manuellen Bearbeitung dutzender Schritte durch eine Person basieren, führen genau dann zu Verzögerungen und Fehlern, wenn es auf Geschwindigkeit ankommt. Hier ist Automatisierung, nicht Dokumentation, der entscheidende Faktor. Tools, die für Massenwiederherstellungen auf einer großen Anzahl von Geräten entwickelt wurden, beseitigen die Abhängigkeit von einem einzelnen Administrator, der während eines Vorfalls alles manuell ausführt.
Workload-Diversität : Ein Plan, der mit einer Datenbank-Engine oder einer Virtualisierungsplattform getestet wurde, lässt sich nicht automatisch auf die anderen zwanzig Arten von Workloads übertragen, die in einem realen Unternehmen ausgeführt werden.
Zusammengenommen ergibt sich ein klares Bild: Ein Plan, der isoliert betrachtet – mit einem Standort, einem Administrator und einem Workload-Typ – funktioniert, ist nicht mehr derselbe, sobald die tatsächliche Größe eines Unternehmens ins Spiel kommt. Eine Organisation mit drei regionalen Rechenzentren, einem Dutzend Anwendungsteams und einer Mischung aus virtualisierter und physischer Infrastruktur testet nicht dasselbe wie eine Organisation mit nur einem Standort und einem System, selbst wenn beide technisch gesehen über einen dokumentierten Plan verfügen.

Die Fähigkeiten, von denen ein getesteter Plan tatsächlich abhängt
Ein Notfallwiederherstellungsplan für Unternehmen ist nur so stark wie die zugrundeliegenden Funktionen. Zwei davon sind besonders wichtig und arbeiten zusammen. Clientseitige Verschlüsselung, bevor Daten das System verlassen, schützt sie im Moment ihrer Erstellung und nicht erst, nachdem sie einen möglicherweise kompromittierten Server erreicht haben. Unveränderlichkeit, gewährleistet durch Mechanismen wie Object Lock, bedeutet, dass selbst bei einem Angreifer mit Administratorrechten die Wiederherstellungskopien nicht gelöscht oder verändert werden können. Diese beiden Funktionen ermöglichen es einem Notfallwiederherstellungsplan, auch in einem Szenario zu bestehen, das immer häufiger bei Vorfällen im Unternehmensmaßstab auftritt: ein Angreifer, der gezielt die Backup-Infrastruktur angreift, um die Wiederherstellung zu verhindern – nicht nur die Produktionssysteme. Genau diese Bedrohung soll ein dedizierter Ransomware-Schutz abwehren.
Die übrigen zugrunde liegenden Funktionen unterstützen dasselbe Ziel aus verschiedenen Blickwinkeln.
- Zugriffskontrolle, die einschränkt, wer Wiederherstellungsdaten ändern kann. Rollenbasierte Zugriffskontrolle, Single Sign-On und Multi-Faktor-Authentifizierung verringern die Wahrscheinlichkeit, dass ein kompromittiertes Konto die Wiederherstellungsfähigkeit beeinträchtigt.
- Die Wiederherstellungsgeschwindigkeit nimmt mit dem Alter der Daten nicht ab. Die Wiederherstellungsindizierung auf Chunk-Ebene bedeutet, dass die älteste Sicherung mit der gleichen Geschwindigkeit wie die neueste wiederhergestellt wird, da nur die benötigten Chunks abgerufen werden.
- Speicher, der skalierbar ist, ohne dass eine Neugestaltung erforderlich ist. Eine speicherunabhängige Architektur mit Deduplizierung reduziert die Betriebskosten für die Skalierung der Wiederherstellungskapazität bei wachsendem Datenvolumen.
- Hybrid-Cloud-Unterstützung für alle Bereitstellungsmodelle. On-Premises, Cloud und Air-Gap-Infrastruktur müssen durch denselben Wiederherstellungsansatz abgedeckt werden, nicht durch drei separate Ansätze.
- Überwachung, die Fehler aufdeckt, bevor sie zu Zwischenfällen werden. Automatisierte Berichtsfunktionen und webhookbasierte Überwachung erkennen einen fehlgeschlagenen oder übersprungenen Sicherungsauftrag lange bevor er für eine Wiederherstellung benötigt wird.
Keine dieser Fähigkeiten allein macht einen Plan testweise. Sie beseitigen jedoch die Ausreden, die technischen Gründe, warum eine Validierungsübung scheitern könnte, die nichts mit der Frage zu tun haben, ob die zugrunde liegende Strategie tragfähig ist.
Worauf Sie bei der Bewertung von Lösungen zur Unternehmenswiederherstellung achten sollten
Ob Sie Ihre aktuelle Konfiguration überprüfen oder eine Änderung bewerten – diese sechs Kriterien unterscheiden eine unternehmensweite Wiederherstellungsfähigkeit, die sich im großen Maßstab bewährt, von einer, die nur auf dem Papier vollständig aussieht.
| Kriterium | Was zu überprüfen | Warum es wichtig ist |
|---|---|---|
| Bereitstellungsmodell | Unterstützt es SaaS, selbstgehostete und vollständig abgeschottete Bereitstellung, oder bindet es Sie an eine bestimmte Lösung? | Unternehmen mit mehreren Standorten betreiben selten ein durchgängig einheitliches Infrastrukturmodell. |
| Arbeitslastabdeckung | Deckt es Ihren tatsächlichen Mix ab – physische Server, VMs, Datenbanken, SaaS-Anwendungen oder nur einen Teil davon? | Ein Plan mit Lücken in der Abdeckung wird nicht getestet, er ist nur teilweise gültig. |
| Sicherheitskontrollen | Wird die Verschlüsselung clientseitig angewendet, bevor die Daten die Quelle verlassen, und wird die Unveränderlichkeit gegenüber kompromittierten Administratoranmeldeinformationen gewährleistet? | Prüft, ob die Wiederherstellungsdaten selbst einen Ransomware-Angriff überstehen können. |
| Erholungsziele | Lässt sich der angegebene Wiederherstellungspunkt bzw. die Wiederherstellungszeit unabhängig überprüfen oder testen, nicht nur dokumentieren? | Das ist die gesamte Unterscheidung, auf der dieser Artikel basiert. |
| Komplexität des Managements | Lassen sich Massenvorgänge und die Wiederherstellung großer Geräteanzahlen automatisieren, oder ist die Wiederherstellung von manuellen, gerätespezifischen Schritten abhängig? | Die manuelle Ausführung ist einer der drei oben genannten Fehlerpunkte. |
| Eigentumsgesamtkosten | Ist die Preisgestaltung pro Arbeitslast vorhersehbar oder skaliert sie unvorhersehbar mit dem Datenvolumen oder dem Datenaustritt? | Kostenüberraschungen während eines realen Vorfalls verschärfen eine ohnehin schon schlechte Situation. |
Eine Lösung, die bei allen anderen Kriterien gut abschneidet, aber dennoch erfordert, dass ein Mensch die Wiederherstellung für jedes der tausend Geräte manuell konfiguriert, hat das zuvor beschriebene Problem der manuellen Ausführung effektiv wieder eingeführt, nur eben in der Evaluierungsphase anstatt in der Vorfallsphase.
Unternehmenswiederherstellung in hybriden Umgebungen
Bei hybriden Infrastrukturen offenbaren sich häufig die Schwächen von Notfallwiederherstellungsplänen. Organisationen, die lokale Server, Cloud-Workloads und teilweise vollständig vom Internet getrennte Systeme betreiben, benötigen einen einheitlichen, erprobten Ansatz für die Unterstützung hybrider Infrastrukturen – nicht drei separate Pläne, die nie gemeinsam getestet wurden.
Das zuvor beschriebene Koordinationsproblem verschärft sich insbesondere in hybriden Umgebungen, da ein Failover zwischen einem lokalen und einem Cloud-basierten System unterschiedliche Tools, Netzwerkpfade und oft auch unterschiedliche Teams erfordert. Eine Wiederherstellungsfunktion, die SaaS-, selbstgehostete und isolierte Bereitstellungen von einer einzigen Plattform aus abdeckt, eliminiert eine ganze Kategorie ungetesteter Übergaben: den Punkt, an dem zwei unterschiedliche Tools während eines tatsächlichen Vorfalls nicht nur einzeln, sondern auch korrekt zusammenarbeiten müssen.
Dies gewinnt mit steigenden Ausfallkosten zunehmend an Bedeutung. Wenn ein Vorfall branchenweit bereits 15,000 US-Dollar pro Minute kostet, ist die zusätzliche Verzögerung, die dadurch entsteht, dass zwei Teams mitten im Vorfall feststellen, dass ihre lokalen und Cloud-Wiederherstellungstools nicht wie erwartet zusammenarbeiten, keine geringfügige Ineffizienz, sondern entscheidet darüber, ob ein Vorfall eingedämmt oder langwierig wird.
Wie Zmanda Pro die Unternehmenswiederherstellung unterstützt
Zmanda Pro bietet seit 2019 Backup-, Wiederherstellungs- und Disaster-Recovery-Lösungen für eine der weltweit größten nationalen Cybersicherheitsorganisationen. Die Lösung ist in sieben Rechenzentren und auf über 500 physischen und virtuellen Servern in einer vollständig abgeschotteten, klassifizierten Umgebung im Einsatz. Es handelt sich um einen Dauerbetrieb unter realen Bedingungen, nicht um einen einmaligen Test. In einer solchen Umgebung würden die zuvor beschriebenen Schwachstellen in der Koordination und manuellen Ausführung sofort zutage treten, wenn die zugrundeliegende Plattform diese nicht bewältigen könnte.
Drei Designentscheidungen ermöglichen dies. Die Bereitstellung passt sich der Umgebung an, anstatt eine bestimmte Architektur aufzuzwingen. Zmanda Pro unterstützt SaaS-, Self-Hosting- und vollständig isolierte Bereitstellungen von derselben Plattform aus. So benötigen hybride oder sensible Umgebungen keine separaten Tools für separate Infrastrukturen. Die Wiederherstellung im großen Maßstab erfolgt automatisiert statt manuell. ZPAT, das Automatisierungstool von Zmanda Pro, verwaltet das Onboarding mehrerer Geräte, die Richtlinienerstellung und die Massenwiederherstellung für Bereitstellungen mit 1,000 oder mehr Geräten. Die Wiederherstellungsdaten sind unabhängig von den Administratorrechten geschützt: Sie werden clientseitig mit AES-256 verschlüsselt, bevor sie die Quelle verlassen. Die Unterstützung von Object Lock auf AWS S3 und Wasabi gewährleistet die Unveränderlichkeit der Daten auch bei kompromittierten Anmeldeinformationen.
- Die Einsatzmöglichkeiten decken jedes Modell ab. SaaS, selbstgehostet oder vollständig Luftspalt, alles von einer einzigen Plattform aus.
- Die Wiederherstellung erfolgt durch Automatisierung in großem Umfang. ZPAT übernimmt das Massen-Onboarding, die Richtlinienverwaltung und die Massenwiederherstellung über eine einzige Bedienerkonsole.
- Der Datenschutz ist mehrschichtig. Die clientseitige AES-256-Verschlüsselung wird mit der Unveränderlichkeit von Objektsperren kombiniert.
- Das Recovery Point Objective bleibt unter einer Stunde. A kontinuierlich inkrementelle Datensicherung Architektur macht das möglich.

Eine Checkliste, um herauszufinden, welches Exemplar Sie tatsächlich besitzen
Sie benötigen keine Zertifizierung durch Dritte, um Ihre eigenen Schwachstellen aufzudecken. Diese sechs Fragen unterscheiden einen dokumentierten Notfallwiederherstellungsplan von einem getesteten.
- Wurde dieser Plan unter Produktionsbedingungen getestet und nicht nur theoretisch erprobt?
- Gilt die dokumentierte Wiederherstellungszeit auch dann, wenn mehrere Systeme gleichzeitig ausfallen, nicht nur eines?
- Wurde das Failover unter den tatsächlichen Bedingungen Ihrer Website und Workload-Komplexität getestet, und nicht nur in einer vereinfachten Testumgebung?
- Wann wurde die letzte vollständige Wiederherstellung tatsächlich überprüft, anstatt nur zu prüfen, ob der Sicherungsauftrag erfolgreich abgeschlossen wurde?
- Hängt die Wiederherstellung vom Wissen eines bestimmten Administrators ab oder kann sie automatisiert oder von einem anderen Teammitglied durchgeführt werden?
- Wurden Unveränderlichkeit und Zugriffskontrollen nicht nur im Hinblick auf versehentliches Löschen, sondern auch unter Berücksichtigung eines Szenarios getestet, in dem administrative Zugangsdaten kompromittiert werden?
Wenn bei mehr als einer dieser Fragen ein ehrliches „Wir nehmen das an“ statt eines „Wir haben es überprüft“ folgt, dann ist das die Lücke, die dieser Artikel aufgerissen hat.
Was tun, wenn man die Antwort kennt?
Ein dokumentierter Plan ist der notwendige erste Schritt. Ihn jedoch als Ziel zu betrachten, birgt genau das Risiko, dem sich die meisten Organisationen aussetzen. Der nächste Schritt ist die Validierung: Der Plan muss anhand eines sich verstärkenden, systemübergreifenden Ausfalls getestet werden, der einen unternehmensweiten Vorfall tatsächlich definiert – und nicht anhand des sauberen Einzelsystem-Szenarios, das die meisten Planspielübungen abdecken.
Die Wiederherstellung von Unternehmensdaten ist keine Funktion, die man kauft, und kein Dokument, das man ablegt. Sie ist der erprobte und wiederholbare Beweis dafür, dass ein Unternehmen nach einer echten Störung den Betrieb tatsächlich wieder aufnehmen kann. Die meisten Unternehmen verfügen über die ersten beiden Bausteine: Datensicherung und einen dokumentierten Wiederherstellungsplan. Nur wenige haben den dritten.
Häufig gestellte Fragen